古書から書体をつくる
小さなパソコンで学習させたモデル
2026年11月13日と14日に行った試みの記録です。目的は、パブリックドメインの古い書物から、書の書体をつくること。技術的な作業はすべて Claude(Opus 5.5、effort は high)が行い、取捨選択は kuma が行いました。
使ったのは2020年の Mac mini(M1チップ、メモリ16GB)一台です。計算機は借りていません。
本
国立国会図書館(NDL)は、スキャンした書物をインターネットで公開しています。資料ごとの書誌に、保護期間が満了しているかどうかが示されています。選んだのは次の五点です。
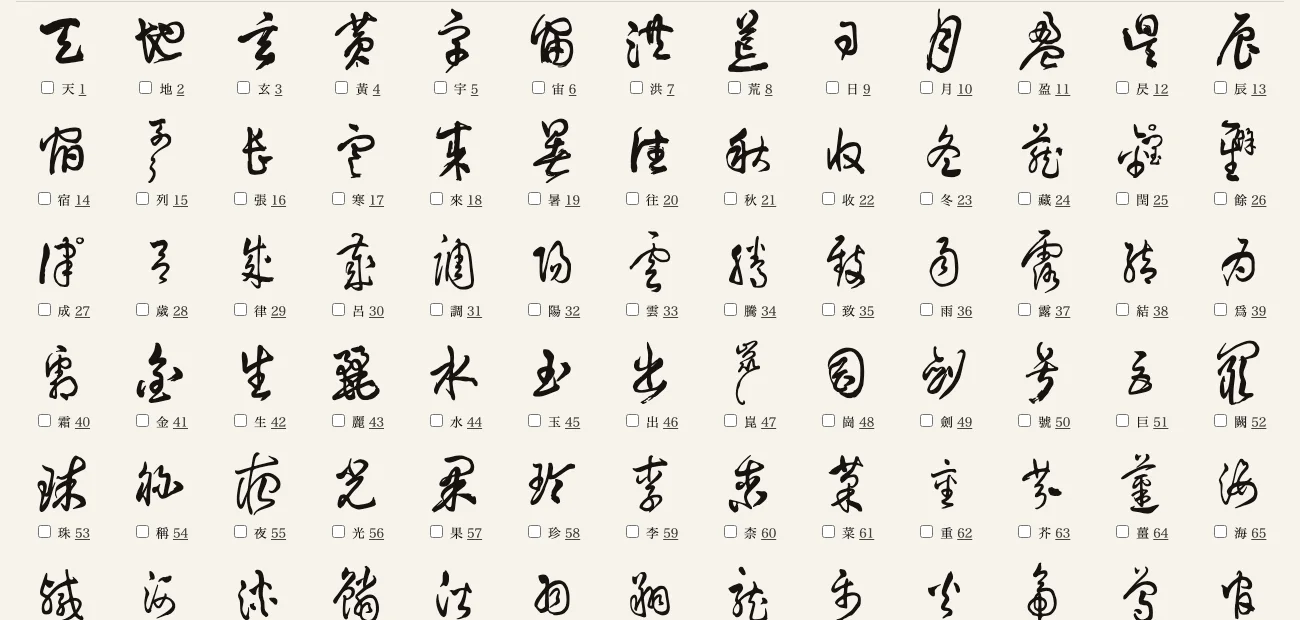
- 池大雅『草書千字文』(天・地)。二冊で、一頁に大字が四字。画家の筆です。
- 小野鵞堂『四体千字文』(1913年)。草書を使いました。
- 高田竹山『六体千字文』(1938年)。古文と篆書を使いました。
- 『十三体千字文』(1884年)。一字ごとに十二の字形が刻まれています。kuma はそのうち十を残しました。
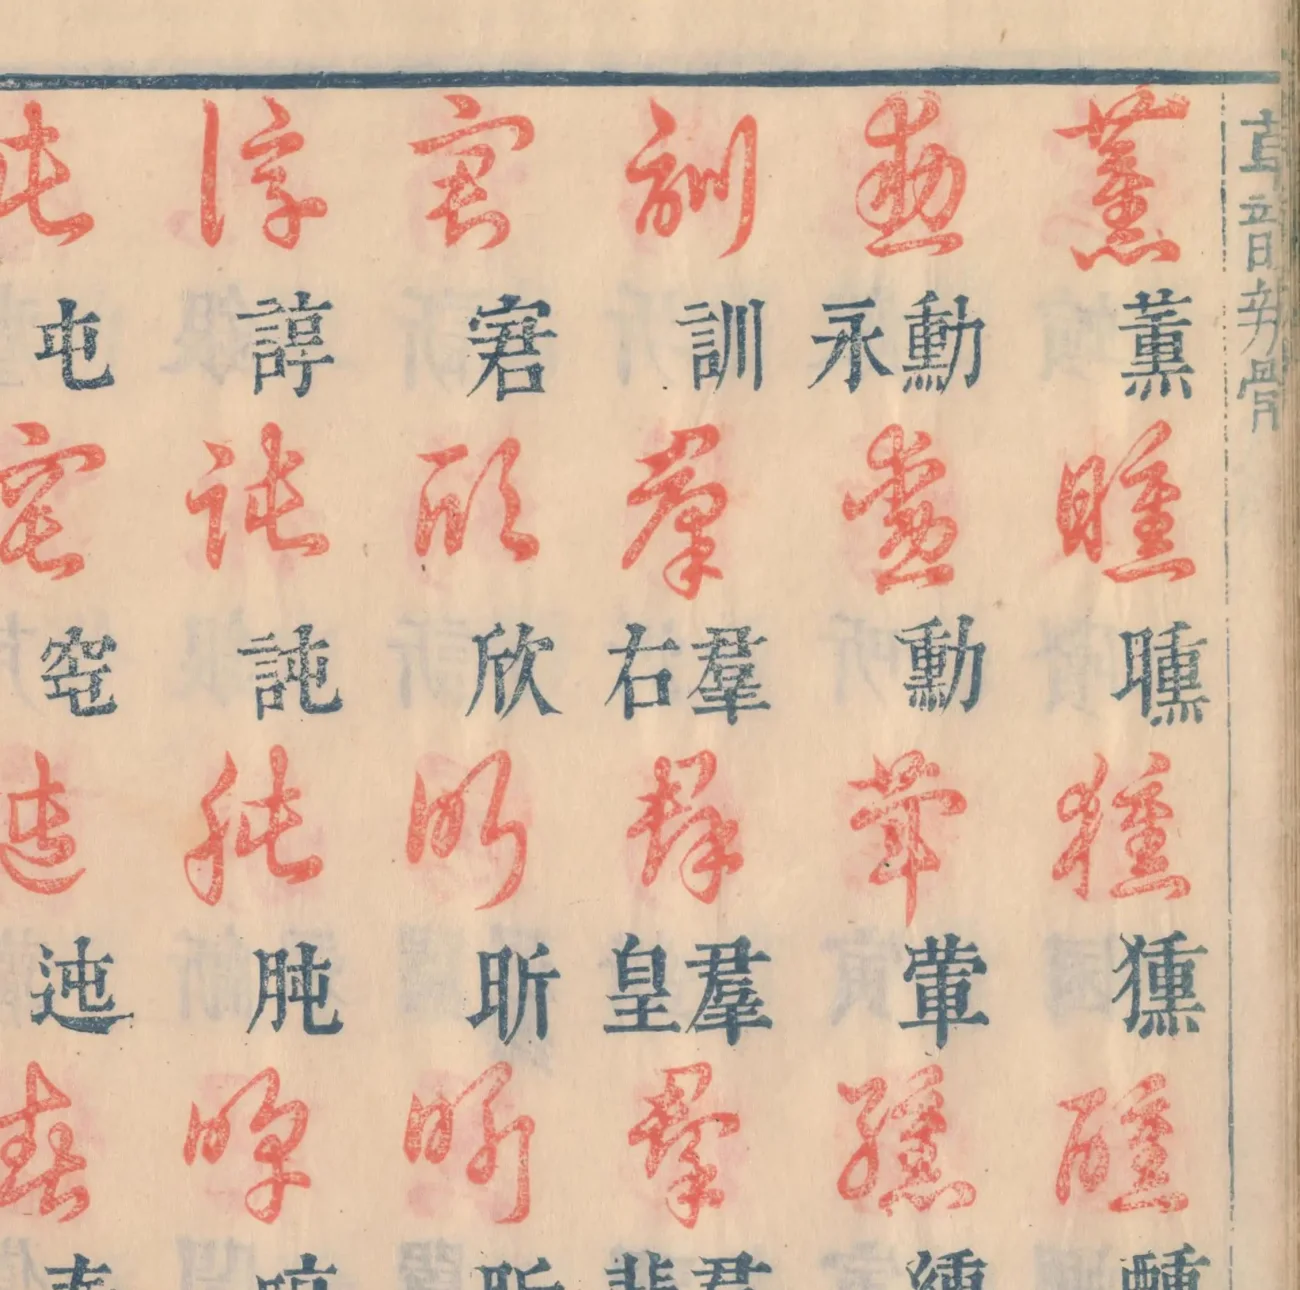
- 『御製草韻辨體』(一・二)。明の万暦帝のもとで編まれた草書の字典で、スキャンされた版は1633年のものです。朱で刷った字形が12,884、その下に見出しの字が藍で刷られています。
なぜ千字文か
千字文は千の字からなる文章で、同じ字は二度出てきません。字の並びもわかっています。ですから字形を切り出せば、文中の位置でどの字かが決まり、字を読み取る必要がありません。
切り出し
切り出しには Python と、画像処理の無料ライブラリ OpenCV を使いました。本ごとに、難しさが違います。
- 池大雅:写真の縁に黒い帯があり、本の折り目も写っています。隣の行にはみ出す字もあります。
- 小野鵞堂:罫線が筆の線に触れています。
- 高田竹山:罫が少し傾いて刷られています。最初の切り出しでは字が欠け、隣の字の点まで拾っていました。そこで、まず頁の罫線をすべて消し、それから墨のかたまりを一つずつ、その中心がある行に振り分けました。
- 十三体千字文:罫線に触れた字が、罫線ごと消えていました。解決は同じで、字を分ける前に罫線を消します。
字形の掃除も要ります。刷った線はまっすぐで、太さが変わりません。筆の線はそうはなりません。この違いを使えば、筆の線に触れずに罫線だけを消せます。はじめに試したもっと単純な規則は、工や直の最後の横画のような、本物のまっすぐな線まで消してしまったので、やめました。
kuma は書体ごとに一字ずつ見直し、うまくいかなかった字形に印をつけます。印の一つひとつが、修正につながります。
二色の字典
『御製草韻辨體』では、色が字形と見出しを分けています。字形は朱、見出しは藍です。Mac には、画像の中の文字を読む Vision という機能が無料で備わっています。藍の見出しを大きさを変えて三回ずつ読ませ、いちばん多かった答えを採りました。読み取った見出しは9,922、字の種類にして4,672。およそ十五に一つは読み誤りです。
書体
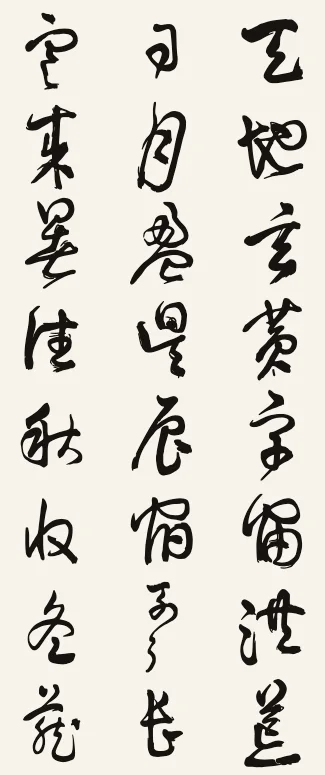
字形を一つずつ正方形に収めます。同じ本の字形はすべて同じ縮尺のままにするので、小さな字は大きな字の隣でも小さいままです。次に、プログラムが字形の輪郭をなぞり、無料のライブラリ opentype.js がその輪郭を書体にまとめます。
古い本に載っているのは旧字です。書体では、その字形を今の字にも使います。たとえば學の字形を、学にも当てます。
モデル
kuma の問いはこうでした。池大雅の千字から、同じ筆で、ほかのすべての字をつくれるか。
この千字だけでは、できません。草書では、字ごとに崩し方が伝統で決まっています。草法です。一度も見たことのない字の草法を、モデルが推し量ることはできません。
そこで本を二つ使いました。草法は字典から、筆は池大雅から取ります。
両方に載っている字は689。字ごとに、池大雅の字形にいちばん近い字典の字形を、プログラムが選びます。十分に近いものがない字もあります。草法が違うか、藍の見出しの読み誤りです。そうした字を除いて、610組が残りました。一組は同じ字の二つの字形、字典のものと池大雅のものです。
そのうち100組は取りのけて、モデルには一度も見せません。モデルの出来を確かめるためです。
モデルは、2017年に発表された pix2pix という手法によります。ある画像を別の画像に変える手法で、二つの部分からなります。一方が字形を描き、もう一方が画像を部分ごとに見て、本物か作り物かを判定します。二つは一緒に学んでいきます。
ソフトは PyTorch で、Mac のグラフィックチップを働かせます。学習は510組で、夜のあいだに4時間。費用はかかっていません。
結果
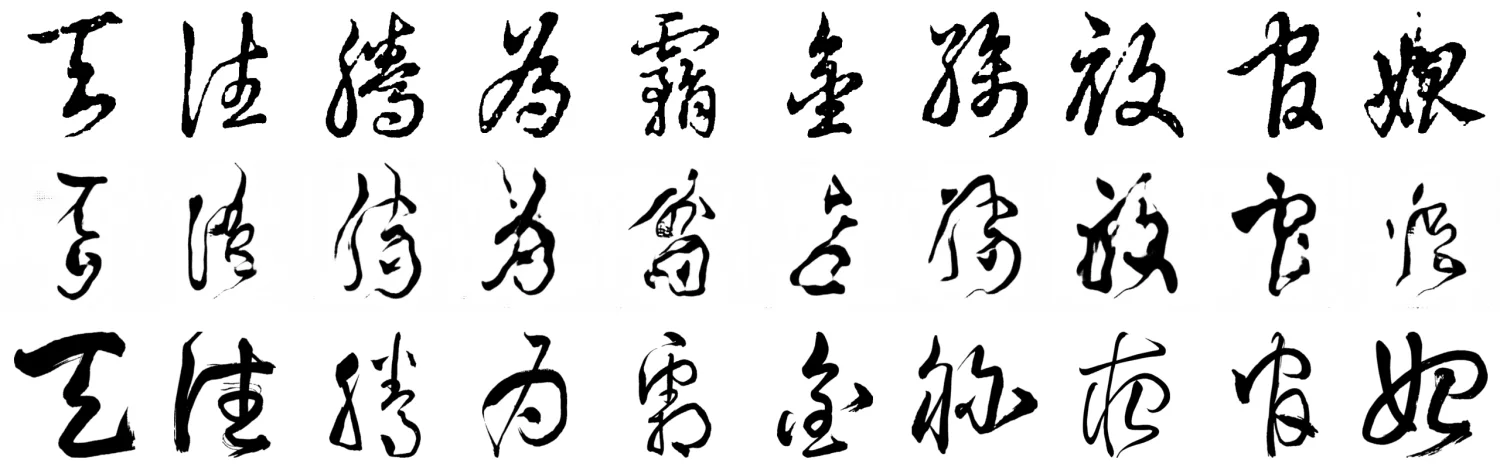
モデルは字典の草法を守ります。けれども線は痩せて薄く、途切れています。池大雅の墨の重さも、勢いもありません。kuma の評は、「面白い」けれど、書体の欠けた字を補うには「読めないし、使えない」。
数字もそれを裏づけます。学習に使った510組では上達しますが、取りのけた100組では上達しません。筆を学ぶのではなく、丸暗記しているのです。
原因は二つ考えられます。まず、510組では少なすぎます。次に、モデルは描いた字形を本物と一点ずつ比べます。ところが、二つの筆跡がぴったり重なることはありません。そこでモデルは平均を描き、平均は痩せてぼやけた線になります。
使ったもの
すべて Mac mini の上で動きました。
- 書物の頁:NDL のサイトから、最大の解像度で。
- 字形の切り出しと掃除:Python と OpenCV。
- 藍の見出しの読み取り:Mac の Vision。
- 書体づくり:opentype.js。
- モデルの学習:PyTorch(グラフィックチップ)。
有料のソフトは使わず、計算機も借りていません。限界はメモリだけです。16GBは小さなモデルには足りますが、大きなモデルには足りません。
この先
この試みから、十七の書体ができました。
ある筆に欠けている字をつくるには、もっと大きなモデルか、すでに多くの筆を学んだモデルが要ります。
誤りや漏れは team@shonoma.com までお知らせください。
des polices tirées de vieux livres, et un modèle entraîné sur un petit ordinateur
ce texte raconte un essai mené les 13 et 14 novembre 2026. le but : créer des polices de calligraphie à partir de livres anciens. ces livres sont dans le domaine public. claude (opus 5.5, effort élevé) a fait tout le travail technique. kuma a fait les choix.
l'ordinateur utilisé est un mac mini de 2020 (puce m1, 16 go de mémoire). aucune machine n'a été louée.
les livres
la bibliothèque nationale de la diète (ndl), à tokyo, met en ligne des livres scannés. pour chaque livre, une fiche indique s'il est dans le domaine public. cinq livres ont été retenus.
- le senjimon en sōsho (草書千字文) d'ike no taiga (池大雅). deux volumes (天, 地), quatre grands caractères par page. c'est la main d'un peintre.
- le senjimon en quatre écritures (四体千字文) d'ono no gadō (小野鵞堂), 1913. le sōsho (草書) a été retenu.
- le senjimon en six écritures (六体千字文) de takada chikuzan (高田竹山), 1938. le kobun (古文) et le tensho (篆書) ont été retenus.
- le senjimon en treize écritures (十三体千字文), 1884. sous chaque caractère, douze formes gravées. kuma en a gardé dix.
- le gyosei sōin bentai (御製草韻辨體, volumes 1 et 2), un dictionnaire de sōsho. il a été compilé en chine sous l'empereur wanli. l'édition scannée date de 1633. il contient 12 884 formes imprimées en rouge. sous chaque forme, le caractère est imprimé en bleu.
pourquoi le senjimon
le senjimon (千字文) est un texte de mille caractères. aucun caractère n'y revient deux fois. l'ordre du texte est connu. quand on découpe une forme, sa place dans le texte donne donc son caractère. inutile de la lire.
le découpage
le découpage se fait avec python et opencv, une bibliothèque libre de traitement d'image. chaque livre pose un problème différent.
- chez ike no taiga, les photos ont des bandes noires sur les bords. le pli du livre se voit aussi. certains caractères débordent sur la colonne voisine.
- chez ono no gadō, les lignes du cadre touchent les traits du pinceau.
- chez takada chikuzan, le cadre est imprimé un peu de travers. le premier découpage coupait des caractères. il prenait aussi des points au caractère voisin. la solution : effacer d'abord toutes les lignes du cadre sur la page. ensuite, chaque tache d'encre va dans la colonne qui contient son centre.
- dans le senjimon en treize écritures, un caractère qui touchait une ligne du cadre partait avec le cadre. la solution est la même : effacer les lignes du cadre avant de séparer les caractères.
il faut aussi nettoyer les formes. une ligne imprimée est droite et d'épaisseur constante. un trait de pinceau ne l'est jamais. cette différence permet d'effacer les lignes sans toucher aux traits. une première règle, plus simple, effaçait aussi de vrais traits droits, par exemple le trait du bas de 工 ou de 直. elle a été abandonnée.
kuma relit chaque police, forme par forme. il coche les formes ratées. chaque coche entraîne une correction.
le dictionnaire en couleur
dans le gyosei sōin bentai, la couleur distingue les formes des caractères : les formes sont rouges, les caractères sont bleus. le mac sait lire un texte dans une image. cette fonction s'appelle vision, et elle est gratuite. elle lit chaque caractère bleu trois fois, à trois tailles. le résultat le plus fréquent est gardé. au total, 9 922 caractères bleus ont été lus. ils correspondent à 4 672 caractères différents. environ une lecture sur quinze est fausse.
la police
chaque forme est placée dans un carré. toutes les formes d'un même livre gardent la même échelle. ainsi, une petite forme reste petite à côté d'une grande. un script trace ensuite le contour de chaque forme. une bibliothèque libre, opentype.js, assemble ces contours en une police.
les livres anciens donnent les caractères anciens. la police s'en sert aussi pour les caractères d'aujourd'hui. par exemple, la forme de 學 sert aussi pour 学.
le modèle
kuma a posé une question : avec les mille caractères d'ike no taiga, peut-on créer tous les autres caractères, dans la même main ?
avec ces mille caractères seuls, la réponse est non. en sōsho, chaque caractère a son abréviation, fixée par la tradition. on l'appelle le sōhō (草法). un modèle ne peut pas deviner le sōhō d'un caractère qu'il n'a jamais vu.
l'essai utilise donc deux livres. le dictionnaire donne le sōhō. ike no taiga donne la main.
689 caractères figurent dans les deux livres. pour chacun, le script choisit la forme du dictionnaire la plus proche de la forme d'ike no taiga. parfois, aucune forme n'est assez proche. dans ce cas, le sōhō est différent, ou la lecture du caractère bleu est fausse. ces caractères sont retirés. il reste 610 paires. chaque paire contient deux formes du même caractère : celle du dictionnaire et celle d'ike no taiga.
100 paires sont mises de côté. le modèle ne les voit jamais. elles servent à le juger.
le modèle suit une méthode publiée en 2017, appelée pix2pix. il transforme une image en une autre. il comprend deux parties. la première dessine la forme. la seconde regarde l'image morceau par morceau et dit si la forme est vraie ou fabriquée. les deux parties apprennent ensemble.
le logiciel s'appelle pytorch. il fait travailler la puce graphique du mac. l'apprentissage a duré quatre heures, de nuit, sur 510 paires. il n'a rien coûté.
le résultat
le modèle garde le sōhō du dictionnaire. mais son trait est maigre, pâle et cassé. on ne retrouve ni le poids de l'encre ni l'élan d'ike no taiga. kuma trouve ces formes « intéressantes », mais « pas lisibles ni utilisables » pour compléter la police.
les mesures confirment cet avis. sur les 510 paires d'apprentissage, le modèle progresse. sur les 100 paires mises de côté, il ne progresse pas. il apprend donc par cœur, au lieu d'apprendre la main.
deux causes sont probables. d'abord, 510 paires, c'est peu. ensuite, le modèle compare son dessin à la vraie forme point par point. or deux mains ne se superposent jamais. le modèle dessine alors une moyenne, et une moyenne donne un trait maigre et flou.
le matériel
tout a tourné sur le mac mini.
- les pages des livres viennent du site de la ndl, en pleine résolution.
- python et opencv découpent et nettoient les formes.
- vision, la fonction du mac, lit les caractères bleus.
- opentype.js crée les polices.
- pytorch entraîne le modèle sur la puce graphique.
aucun logiciel payant. aucune machine louée. la seule limite est la mémoire : 16 go suffisent pour un petit modèle, mais pas pour un grand.
la suite
l'essai a donné dix-sept polices.
pour créer les caractères qui manquent à une main, il faut un modèle plus grand, ou un modèle qui a déjà appris beaucoup de mains.
une erreur, un oubli ? écrivez à team@shonoma.com.